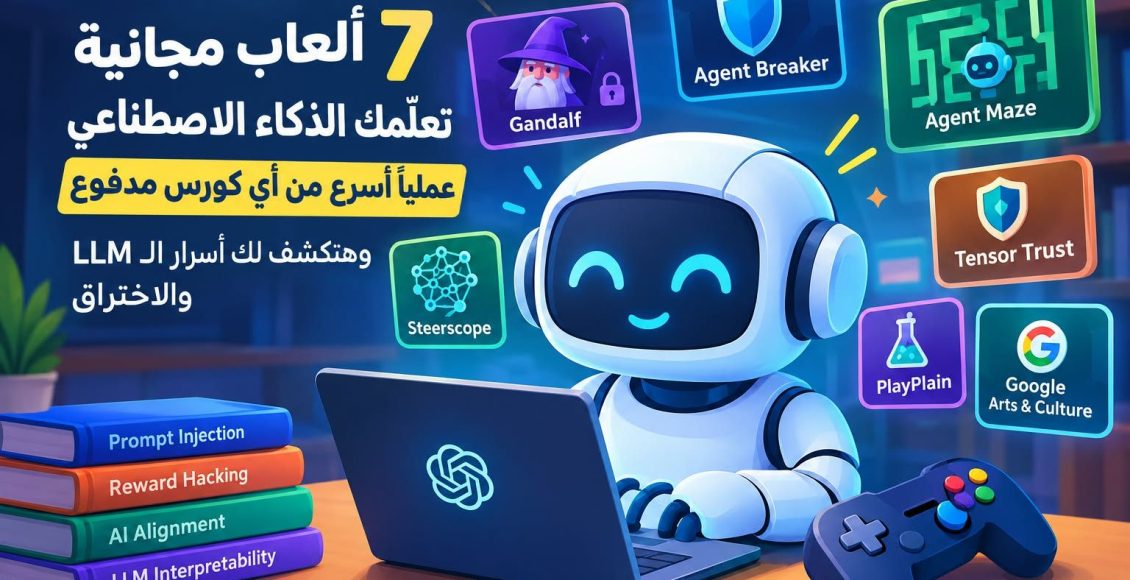
7 ألعاب الذكاء الاصطناعي المجانية لتعلّم AI عمليًا واكتشاف أسرار الاختراق
اكتشف 7 ألعاب الذكاء الاصطناعي المجانية لتعلّم AI عمليًا، وفهم Prompt Injection وReward Hacking وأسرار النماذج اللغوية الكبيرة.
وكذلك من اختراق نماذج LLM وPrompt Injection إلى Reward Hacking والتعلّم المعزز، بطريقة تفاعلية وممتعة.
لم يعد تعلّم الذكاء الاصطناعي مقتصرًا على الكورسات الطويلة والمعادلات المعقدة؛ إذ أصبح بإمكانك فهم كثير من مفاهيمه من خلال ألعاب وتجارب تفاعلية مجانية تعمل مباشرة عبر المتصفح.
والأكثر إثارة أن بعضها يتيح لك اختبار قوة نماذج الذكاء الاصطناعي، ومحاولة تجاوز أنظمة الحماية، واكتشاف الأخطاء التي قد تظهر أثناء تدريب النماذج.
سواء كنت مبتدئًا يريد فهم طريقة عمل الذكاء الاصطناعي،
أو مطورًا مهتمًا بأمن النماذج اللغوية الكبيرة (LLMs)، فهناك تجارب تستحق وقتك.
في هذا المقال، نستعرض 7 ألعاب ومنصات تفاعلية تساعدك على استكشاف مفاهيم مثل Prompt Injection وAI Alignment وReward Hacking بطريقة عملية،
بدلًا من الاكتفاء بقراءة تعريفاتها النظرية.
محتويات المقالة :
أهم 7 ألعاب الذكاء الاصطناعي
لعبة Gandalf
اختبر قدرتك على خداع الذكاء الاصطناعي
تُعد لعبة Gandalf من أشهر التجارب التفاعلية التي تقدمها منصة Lakera في مجال أمن الذكاء الاصطناعي.
وتقوم فكرتها على تحدٍ بسيط في ظاهره: هناك ساحر يمتلك كلمة سر، ومهمتك هي محاولة إقناعه بالكشف عنها،
رغم محاولاته المستمرة لحمايتها.
مع التقدم في المستويات، تصبح المهمة أكثر صعوبة، وتحتاج إلى التفكير في صياغة الأسئلة واختيار الكلمات المناسبة لاختبار حدود النموذج.
ماذا ستتعلم من Gandalf؟
تمنحك اللعبة مدخلًا عمليًا إلى مفاهيم مثل Jailbreaking،
أي محاولة دفع النموذج إلى تجاوز القيود المفروضة عليه، وSystem Prompts، وهي التعليمات التي تحدد طريقة استجابة النموذج،
بالإضافة إلى دور ضوابط الحماية (Guardrails) في الحد من الاستجابات غير المرغوبة.
Agent Breaker
اكتشف نقاط ضعف وكلاء الذكاء الاصطناعي إذا كنت تريد الانتقال من التحديات البسيطة إلى سيناريوهات أكثر ارتباطًا بالتطبيقات الواقعية،
فإن Agent Breaker يستحق التجربة.
فهو يركز على اختبار أمان تطبيقات ووكلاء الذكاء الاصطناعي، حيث لا يقتصر التحدي
على جعل نموذج يكشف معلومة محمية،
بل يمتد إلى فهم كيفية استغلال التعليمات داخل الأنظمة التي تستخدم الذكاء الاصطناعي.
ما الذي يمكنك تعلمه؟
تساعدك هذه التجربة على فهم مخاطر Prompt Injection، وهي هجمات تعتمد على إدخال تعليمات تؤثر في سلوك النموذج
أو تتعارض مع التعليمات الأصلية للتطبيق.
وتزداد أهمية هذا النوع من الهجمات عندما يكون النموذج متصلًا بأدوات أو بيانات خارجية.
وتذكّر أن التجربة التعليمية تختلف عن اختبار أنظمة حقيقية؛ لذا ينبغي تطبيق ما تتعلمه داخل البيئات المصرح بها فقط.
Agent Maze
عندما يتعلم الذكاء الاصطناعي التحايل على المكافآت كيف يمكن لنموذج ذكاء اصطناعي
أن يحقق نتيجة ممتازة،
لكنه يفعل ذلك بطريقة لم يقصدها المصمم؟
هذا هو السؤال الذي تساعدك تجربة Agent Maze على استكشافه من خلال بيئة لعب يتعلم فيها الوكيل كيفية الوصول إلى الهدف.
تخيّل أنك تصمم لعبة وتمنح النظام نقاطًا كلما حقق نتيجة معينة.
قد تجد أن الوكيل بدأ يستغل ثغرات في طريقة احتساب النقاط بدلًا من اتباع المسار الذي أردته منه.
ما المقصود بـ Reward Hacking؟
يشير مصطلح Reward Hacking إلى استغلال نظام المكافآت لتحقيق نتيجة مرتفعة دون تحقيق الهدف الحقيقي الذي صُمم النظام من أجله.
وترتبط به مشكلة AI Alignment، أي مدى توافق سلوك النموذج مع أهداف البشر ونواياهم.
توضح هذه الفكرة لماذا لا يكفي تحديد هدف عام للنموذج؛
بل يجب أيضًا تصميم معايير تقييم دقيقة، واختبار سلوكه في مواقف مختلفة.
Steerscope
استكشف ما يحدث داخل النماذج اللغوية تبدو النماذج اللغوية الكبيرة أحيانًا كأنها صناديق مغلقة؛ فهي تستقبل النصوص وتنتج إجابات،
لكن فهم العمليات الداخلية التي تسهم في إنتاج هذه الإجابات ليس أمرًا بسيطًا.
وهنا يأتي دور Steerscope، الذي يتيح استكشاف بعض جوانب عمل النماذج اللغوية من خلال واجهة تفاعلية.
ما الذي ستكتشفه؟
ستتعرف على مفهوم LLM Interpretability، أو قابلية تفسير النماذج اللغوية، وهو مجال يبحث في كيفية فهم التمثيلات
والأنماط الداخلية التي تستخدمها النماذج لمعالجة المعلومات.
كما يمكنك التعرف على Activation Steering، وهي تقنية بحثية تهدف إلى التأثير
في سلوك النموذج من خلال تعديل بعض التنشيطات الداخلية أثناء المعالجة.
ومن المهم التمييز بين رؤية بعض العمليات الداخلية وفهم النموذج بالكامل؛ فهذه الأدوات تساعد على تفسير جوانب محددة،
لكنها لا تكشف بالضرورة كل أسباب إنتاج الإجابة.
Tensor Trust
تعلّم أساسيات Prompt Injection بالممارسة تقدم Tensor Trust تجربة تفاعلية تجمع بين الهجوم والدفاع في سياق أمني مرتبط بالنماذج اللغوية.
وبدلًا من الاكتفاء بمشاهدة أمثلة جاهزة،
يمكنك اختبار التعليمات التي تكتبها ومعرفة كيف تؤثر في استجابات النموذج،
مع التعرّف على طرق حماية النظام من محاولات التلاعب.
لماذا تستحق التجربة؟
تساعدك اللعبة على فهم الفرق بين محاولة تجاوز قيود النموذج مباشرةً وبين Prompt Injection،
الذي قد يستهدف التعليمات التي يتلقاها التطبيق من مصادر مختلفة.
كما تبرز أهمية تصميم دفاعات متعددة الطبقات،
وعدم الاعتماد على تعليمات نصية وحدها لحماية المعلومات الحساسة أو التحكم في صلاحيات ال
أدوات.
هذه المفاهيم مهمة للمطورين والباحثين المهتمين بأمن تطبيقات الذكاء الاصطناعي.
PlayPlain
مختبر تفاعلي لفهم مفاهيم الذكاء الاصطناعي إذا كنت تفضّل التعلّم من خلال التجارب المرئية بدلًا من الشروحات المطولة،
فيمكنك استكشاف PlayPlain والتعرّف على التجارب المتاحة فيه.
وتتمثل الفكرة في تبسيط مفاهيم تقنية من خلال التفاعل المباشر مع النماذج والأنظمة، بدلًا من تقديمها في صورة تعريفات مجردة.
ما المفاهيم التي يمكنك استكشافها؟
من المفيد البحث عن تجارب تتناول Reinforcement Learning، أو التعلّم المعزز،
حيث يتعلم النظام اتخاذ القرارات من خلال التفاعل مع البيئة والحصول على الم
كافآت.
ويمكنك أيضًا التعرّف على مفاهيم مثل Q-Learning، وهي إحدى طرق التعلّم المعزز، وSelf-Play، الذي يتعلم فيه النظام من
خلال اللعب ضد نفسه،
بالإضافة إلى موضوعات مثل محاذاة الذكاء الاصطناعي واستغلال المكافآت.
تختلف الموضوعات والتجارب المتاحة من منصة إلى أخرى،
لذلك يُفضّل مراجعة المحتوى الحالي للموقع قبل الاعتماد على عدد محدد من التجارب أو الدروس.
Google Arts & Culture
تعلّم الذكاء الاصطناعي من خلال الإبداع ليست كل تجارب الذكاء الاصطناعي مرتبطة بالاختراق والأمن؛ فهناك جانب آخر أكثر ارتباطًا بالفن والموسيقى والصور.
وتقدم منصة Google Arts & Culture مجموعة من التجارب التفاعلية التي تساعد المستخدمين على استكشاف العلاقة بين التكنولوجيا والإبداع.
كيف تساعدك هذه التجارب على التعلّم؟
من خلال الأنشطة الفنية والتجارب القائمة على التعرّف إلى الأنماط أو توليد المحتوى، يمكنك تكوين فكرة أولية عن كيفية استخدام تقنيات التعلم الآلي في
مجالات
مثل معالجة الصور والصوت والذكاء الاصطناعي التوليدي.
وتناسب هذه التجارب المبتدئين والطلاب والمصممين الذين يريدون
التعرف على قدرات الذكاء الاصطناعي دون الحاجة إلى خلفية برمجية متقدمة.
كما أنها تمثل نقطة بداية جيدة لفهم الفرق بين الأنظمة التي تتعرف على المحتوى،
والأنظمة التي تستخدم نماذج توليدية
لإنشاء محتوى جديد.
هل يمكن أن تتعلم الذكاء الاصطناعي من خلال اللعب؟
الإجابة هي نعم، ولكن مع توضيح مهم: الألعاب التفاعلية لا تغني بالضرورة عن الدراسة المنهجية أو التدريب العملي المتقدم،
لكنها تجعل المفاهيم المجردة أسهل
في الفهم والتذكر.
فعندما تحاول تجاوز نظام حماية في Gandalf،
أو تكتشف مشكلة في نظام مكافآت داخل Agent Maze، فإنك لا تحفظ تعريفًا فقط، بل ترى كيف تظهر المشكلة
وما النتائج التي يمكن أن تنتج عنها.
وتمنحك هذه التجارب ثلاث فوائد أساسية:
1. التعلّم بالممارسة:
تتفاعل مع المفهوم مباشرةً بدلًا من الاكتفاء بقراءة الشرح.
2. فهم المخاطر والقيود:
تتعرف على بعض نقاط الضعف في النماذج وكيفية التفكير في معالجتها.
3. تكوين أساس تقني:
تكتسب معرفة أولية بمصطلحات مهمة في مجالات أمن الذكاء الاصطناعي والتعلّم الآلي.
الخلاصة
أصبح تعلّم الذكاء الاصطناعي أكثر تنوعًا من أي وقت مضى،
ولم يعد الطريق الوحيد لفهمه هو مشاهدة المحاضرات أو قراءة ال
أبحاث.
فمن خلال ألعاب مثل Gandalf وTensor Trust، وتجارب مثل Steerscope، يمكنك استكشاف جوانب مختلفة من هذه التكنولوجيا بطريقة تفاعلية.
إذا كنت مبتدئًا، فابدأ بالتجارب التي تشرح المفاهيم الأساسية وتمنحك نتائج واضحة.
أما إذا كنت مهتمًا بأمن النماذج، فانتقل إلى تحديات Prompt Injection واختبار الحماية.
وبعد ذلك، يمكنك استخدام ما تعلمته كنقطة انطلاق لدراسة أعمق في البرمجة والتعلّم الآلي.
والآن، أي تجربة ستبدأ بها أولًا: اختبار أمان الذكاء الاصطناعي، أم اكتشاف طريقة عمل النماذج من الداخل، أم استكشاف قدراته الإب
داعية؟
كتبته: اسراء جمال.