نموذج ذكاء اصطناعي لتحويل الصور إلى فيديو ناطق مجانًا من Meituan: ثورة في عالم الفيديو
اكتشفي نموذج Meituan للذكاء الاصطناعي لتحويل الصور إلى فيديو ناطق، مع مزامنة الشفاه بالصوت، وأهم المميزات والاستخدامات المحتملة.
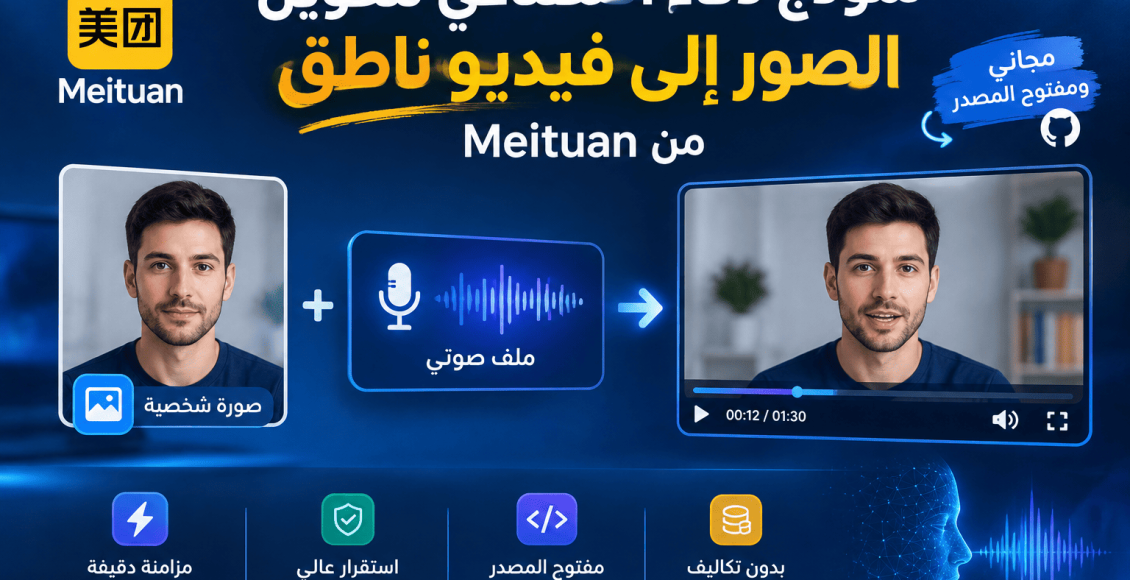
تخيّل أن تمتلك صورة شخصية عادية وملفًا صوتيًا قصيرًا، ثم تتمكن من تحويلهما إلى فيديو يظهر فيه الشخص وكأنه يتحدث أمام الكاميرا، مع حركة شفاه متزامنة مع الكلمات وتعبيرات وجه تبدو طبيعية!
ما كان يتطلب في السابق معدات تصوير وبرامج مونتاج متخصصة وميزانيات كبيرة، أصبح اليوم أقرب إلى متناول المطورين وصناع المحتوى بفضل التطور المتسارع في تقنيات الذكاء الاصطناعي.
ومع انتشار الأخبار عن نماذج مفتوحة المصدر طورتها فرق تقنية صينية، من بينها فريق Meituan، عاد سؤال مهم إلى الواجهة:
هل اقتربنا من عصر إنشاء الفيديوهات الاحترافية دون الحاجة إلى اشتراكات باهظة أو استوديوهات متكاملة؟
في هذا المقال، نستكشف فكرة نموذج ذكاء اصطناعي لتحويل الصور إلى فيديو ناطق
محتويات المقالة :
ما هو نموذج Meituan للذكاء الاصطناعي الذي يحوّل الصور إلى فيديو؟
تقوم فكرة هذه التقنية على استخدام صورة لشخص وملف صوتي لتوليد فيديو يحاكي حديثه.
بدلًا من الاكتفاء بعرض صورة ثابتة مع صوت في الخلفية، يحاول النموذج إنتاج حركة مرئية تتوافق مع الكلام، خصوصًا حركة الفم والشفتين.
وتعتمد هذه الفئة من التقنيات على نماذج الذكاء الاصطناعي التوليدي التي تتعلم العلاقة بين الصوت والحركات المرئية للوجه، ثم تستخدم ما تعلمته لإنشاء إطارات فيديو متتابعة.
وتكمن أهمية هذه الفكرة في أنها تفتح الباب أمام إنتاج محتوى مرئي دون الحاجة إلى تصوير الشخص في كل مرة، وهو ما قد يفيد المعلمين والمسوقين وصناع الفيديو والمطورين.
لكن من المهم التمييز بين انتشار خبر عن نموذج معين وبين التحقق من تفاصيله التقنية؛ فاسم Meituan وحده لا يكفي لإثبات أن النموذج المقصود يدعم جميع الميزات المتداولة أو أنه مجاني بالكامل في كل بيئات التشغيل.
كيف تعمل تقنية تحويل الصورة والصوت إلى فيديو ناطق؟
تعتمد العملية عادةً على مجموعة من الخطوات التقنية التي تعمل معًا لإنتاج النتيجة النهائية:
1. رفع الصورة الشخصية
يبدأ المستخدم باختيار صورة واضحة يظهر فيها الوجه، ويفضل أن تكون الإضاءة جيدة وأن تكون ملامح الفم والوجه ظاهرة. جودة الصورة قد تؤثر بصورة مباشرة في جودة الفيديو الناتج.
2. إضافة الملف الصوتي
بعد ذلك، يُضاف تسجيل صوتي يتضمن الكلام المراد عرضه. وقد تختلف صيغ الملفات المدعومة ومدتها بحسب النموذج وأدوات التشغيل المستخدمة.
3. تحليل الصوت وحركة الكلام
يحلل النظام الإشارات الصوتية وتوقيت الكلمات والمقاطع، ثم يحاول ربطها بحركات الفم المناسبة. وتُعد مزامنة الشفاه بالذكاء الاصطناعي من أهم عناصر نجاح هذه التقنية، لأن أي اختلاف واضح بين الصوت وحركة الفم قد يجعل الفيديو غير مقنع.
4. توليد الإطارات وتحريك الوجه
يُنشئ النموذج سلسلة من الإطارات التي تحاكي الحديث، مع محاولة الحفاظ على هوية الشخص وملامحه الأساسية. وقد تشمل النتائج حركات إضافية في الرأس والوجه، لكن مستوى واقعيتها يختلف من نموذج إلى آخر.
5. إخراج الفيديو النهائي
تُجمع الإطارات في فيديو متصل بالصوت الأصلي أو الصوت المعالج، بحسب آلية عمل الأداة. وهنا تظهر الفروق بين النماذج في سلاسة الحركة وثبات الملامح وجودة التزامن.
لماذا تحظى النماذج مفتوحة المصدر بكل هذا الاهتمام؟
السبب لا يقتصر على جودة الفيديو، بل يتعلق أيضًا بحرية الاستخدام وإمكانية الوصول إلى التقنية.
عندما يكون النموذج مفتوح المصدر بالفعل، ويتيح ترخيصه الاستخدام المطلوب، يستطيع المطورون فحص الشيفرة وتعديلها ودمجها في مشاريعهم، بدلًا من الاعتماد الكامل على منصة مغلقة.
ومن أبرز المزايا المحتملة:
- تقليل التكاليف: قد يتمكن المستخدم من تشغيل النموذج دون دفع رسوم اشتراك لكل فيديو، مع مراعاة تكاليف الأجهزة والكهرباء والاستضافة.
- مرونة أكبر للمطورين: إمكانية دمج التقنية في تطبيقات ومواقع وخدمات مختلفة وفقًا لشروط الترخيص.
- التحكم في البيانات: التشغيل المحلي قد يقلل الحاجة إلى إرسال الصور والتسجيلات إلى خدمات خارجية.
- تجارب وتطوير أسرع: يستطيع مجتمع المطورين اختبار الأداء واقتراح التحسينات وبناء أدوات إضافية.
- فرص جديدة للشركات الناشئة: قد تصبح بعض تطبيقات الفيديو أكثر سهولة من حيث التكلفة والتطوير.
ومع ذلك، فإن وصف نموذج بأنه «مفتوح المصدر ومجاني 100%» يحتاج إلى تدقيق.
فقد تكون الشيفرة متاحة مجانًا، بينما يتطلب التشغيل بطاقة رسومية قوية أو مساحة تخزين أو خدمات مدفوعة. كما أن تراخيص الأوزان البرمجية قد تفرض شروطًا تختلف عن تراخيص الشيفرة نفسها.
كيف يستفيد صناع المحتوى والمسوقون من هذه التقنية؟
تخيل أن لديك متجرًا إلكترونيًا في السعودية أو مصر، وتريد تقديم شرح سريع لمنتجاتك دون تصوير إعلان جديد لكل منتج. قد تساعدك تقنيات الصور الناطقة في إنتاج مقاطع تعريفية
باستخدام شخصية افتراضية أو متحدث وافق على استخدام صورته وصوته.
وفي مجال التعليم، يمكن استخدامها لتطوير شروحات مرئية أو شخصيات تعليمية تتحدث بلغات متعددة، بحسب قدرات النموذج وجودة الأصوات المتاحة.
أما صناع المحتوى، فقد يستفيدون منها في إعداد نماذج أولية للإعلانات، وتجربة أفكار مختلفة، وإنتاج فيديوهات قصيرة لمنصات التواصل الاجتماعي.
وتشمل الاستخدامات المحتملة أيضًا خدمة العملاء، والعروض التقديمية، والمحتوى التدريبي، والتجارب التفاعلية داخل التطبيقات.
لكن التقنية ليست حلًا سحريًا لكل سيناريو؛ فالفيديوهات الطويلة قد تتطلب موارد حوسبة أكبر، وقد تظهر فيها مشكلات مثل تغير الملامح أو الحركة غير الطبيعية أو ضعف التزامن.
لذلك يُفضّل اختبار عينة قصيرة قبل بناء مشروع كامل عليها.
هل تستطيع النماذج المجانية إنهاء عصر أدوات الفيديو المدفوعة؟
الإجابة ليست بهذه البساطة. فالنماذج المفتوحة المصدر قد تضغط على أسعار الخدمات التجارية، وتمنح المستخدمين خيارات أكثر، لكنها لا تعني بالضرورة اختفاء الأدوات المدفوعة.
فالمنصات التجارية قد تقدم واجهات استخدام سهلة، ودعمًا فنيًا، ومعالجة سحابية سريعة، وتكاملًا مع أدوات تحرير الفيديو، وضمانات أوضح بشأن الخصوصية وحقوق الاستخدام.
وهذه مزايا قد تكون مهمة للشركات التي تحتاج إلى إنتاج مستمر وموثوق.
في المقابل، قد يفضّل المطورون وأصحاب الخبرة التقنية النماذج المحلية لما توفره من مرونة وتحكم أكبر.
لذلك، يبدو السيناريو الأقرب هو زيادة المنافسة بين الحلول المجانية والمدفوعة، لا اختفاء أحد الطرفين بصورة فورية. وسيكون الفائز هو الحل الذي يقدم أفضل توازن بين الجودة والتكلفة والسرعة وسهولة الاستخدام.
ما الذي يجب التحقق منه قبل تجربة النموذج؟
قبل تنزيل أي مستودع برمجي متداول على منصات التواصل الاجتماعي، تأكد من الوصول إلى المستودع الرسمي، وراجع اسم الجهة المطورة وتاريخ التحديثات وشروط الترخيص.
تحقق أيضًا من متطلبات التشغيل، وحجم الملفات المطلوب تنزيلها، ونوع بطاقة الرسومات المناسبة، وما إذا كانت هناك قيود على الاستخدام التجاري.
ولا تفترض أن كل مشروع منشور على GitHub آمن أو أن جميع الملفات المرتبطة به موثوقة.
ومن الناحية الأخلاقية، ينبغي الحصول على موافقة صاحب الصورة والصوت قبل إنشاء فيديو يحاكي حديثه، مع توضيح أن المحتوى مولّد بالذكاء الاصطناعي عندما يكون ذلك ضروريًا لتجنب التضليل أو انتحال الشخصية.
الخلاصة: مستقبل الفيديو أصبح أكثر انفتاحًا
إن تطور نماذج الذكاء الاصطناعي لتحويل الصور إلى فيديو ناطق يمثل خطوة مهمة نحو جعل إنتاج المحتوى المرئي متاحًا لشريحة أوسع من المستخدمين. فالجمع بين صورة واحدة وتسجيل صوتي قد يختصر مراحل من العمل، ويفتح فرصًا جديدة أمام المطورين والمسوقين والمعلمين.
أما الحديث عن نموذج Meituan تحديدًا، فيستحق الاهتمام مع ضرورة الرجوع إلى المستودع الرسمي للتحقق من قدراته الفعلية وشروط استخدامه وتكاليف تشغيله، بدلًا من الاعتماد على الادعاءات المتداولة وحدها.
قد لا تنتهي أدوات الفيديو المدفوعة قريبًا، لكن المنافسة تتغير بالفعل: فكلما أصبحت النماذج المفتوحة أكثر كفاءة وسهولة، ازدادت فرص الأفراد والشركات الصغيرة في إنتاج محتوى احترافي بتكلفة أقل.
والسؤال الأهم لم يعد فقط: هل يمكن للذكاء الاصطناعي تحريك صورة؟ بل أصبح: كيف سنستخدم هذه القدرة بطريقة مبتكرة ومسؤولة، ونحوّلها إلى قيمة حقيقية في عالم المحتوى الرقمي؟
كتبته: اسراء جمال.